この記事の要点
RAG(検索拡張生成)で問われるのは、問いかけのたびに新しいデータを、使える形で、すぐに届けられるかどうかである。
構成が複雑になる原因は製品の性能差ではなく、保存・整形・検索という 3 つの役割が別々の製品に分かれていることにある。
VAST AI Operating System(VAST AI OS)は同じ基盤の上にデータベースを持ち、保存と同時に整形する。外付けのベクトルデータベースとパイプライン専用の Kubernetesクラスタが要らなくなる。
リード
生成AI の活用は、モデルを作る「学習」から、業務の中でモデルを使い続ける「推論」へと重心が移りつつあります。推論の時代に問われるのは、モデルの性能だけではありません。モデルが回答を出すその瞬間に、必要なデータを、使える形で、すぐに届けられるかどうかです。
推論を支えるデータの仕組みにはいくつかの種類があり、社内のドキュメントを根拠に回答させるRAG(検索拡張生成)もそのひとつです。RAG は推論の一部ですが、推論の回答を社内の知識に基づいたものにする重要なポイントです。そこで本記事では、RAG に焦点を絞って説明します。
RAGを本番で動かそうとすると、ストレージ、前処理ツール、ベクトルデータベース、処理を動かす実行基盤と、組み合わせる製品が次々に増えていきます。以下では、この構成がなぜ複雑になるのかを整理し、データベースを内包した VAST AI Operating System (VAST AI OS)がそれをどうシンプルにするのかを、1枚の全体図に沿って解説します。
この記事の対象者
社内データを使ったRAGを検討している、インフラ・ストレージ担当の技術者の方
VAST Dataの提案や導入に携わっている、パートナー企業の技術者の方
VAST Dataを導入済みで、AI活用への展開を検討している方
RAG の基本的な仕組みを聞いたことがあれば読み進められます。VAST Dataの製品知識は必要ありません。読了の目安は約10分です。
RAGがデータ基盤に求めること
RAG では、利用者やAIエージェントから問いかけがあるたびに、その場で必要な情報を社内のデータから探し出し、回答の根拠としてモデルに渡します。そのため、データ基盤には次の 3 つが求められます。
鮮度:新しい資料や更新された情報が、すぐに回答に反映されること
形式:文書がそのままではなく、検索できる形(ベクトル)に整えられていること
即応性:問いかけのたびに、大量のデータの中から関連する情報をすぐに探し出せること
RAG の利用が広がり、問いかけの数やデータの量が増えるほど、この 3 つを満たし続けることが難しくなっていきます。
RAG の構成は、なぜ複雑になるのか
この 3 つを一般的な製品の組み合わせで満たそうとすると、多くの場合、次のような構成になります。
元データを保管するファイルサーバやオブジェクトストレージ
文書を分割してベクトルに変換する処理と、それを動かすKubernetesなどの実行基盤
ベクトルを格納して検索するベクトルデータベース
構成が複雑になる理由は、データを「保存する」「AI が使える形に整える」「検索する」という3つの役割が、それぞれ別の製品に分かれていることにあります。製品の間でデータをコピーし、同期を取り続けなければならず、そのすき間で鮮度が落ちていきます。RAG の規模が大きくなるほど、製品の数だけ運用する対象も増えていきます。
VAST AI OSとは:ストレージではなく「AI のためのデータ基盤」
図1は、VAST AI OS のデータ基盤部分を1枚にまとめたものです(図中では「VAST Data Platform」と表記しています)。左の「取り込み」、中央の「保存と整形」、右の「利用」という3つの領域に分けて読むとわかりやすくなります。
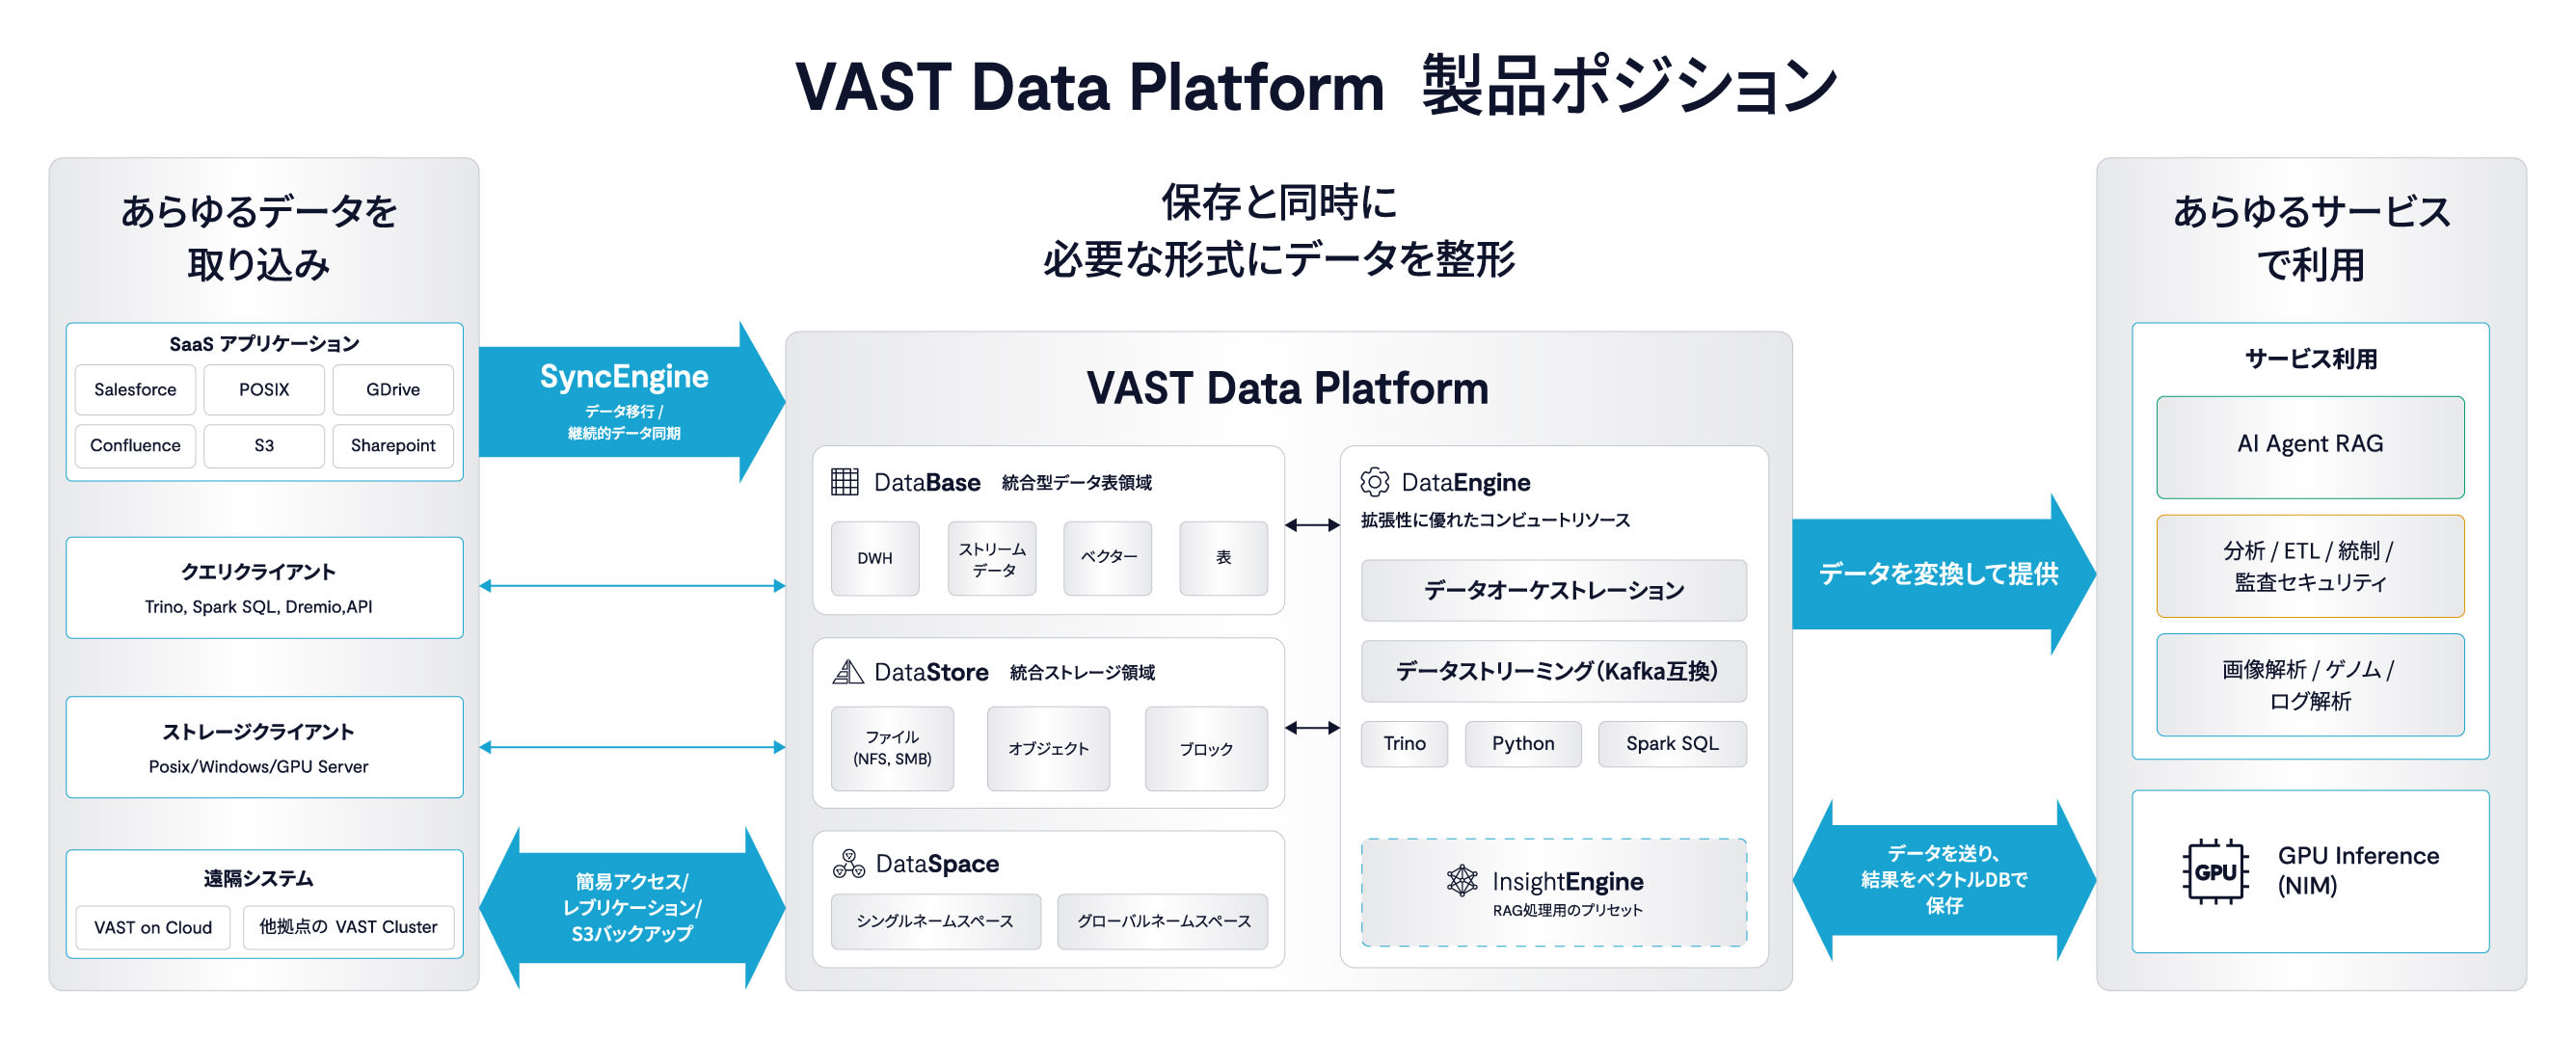
図1 VAST AI OS の全体像。左から「取り込み」「保存と整形」「利用」の順にデータが流れる
中核となるのは、中央にある次の4つの要素です。
VAST DataStore:ファイル(NFS、SMB)、オブジェクト(S3)、ブロックを同じ基盤で扱う統合ストレージ領域
VAST DataBase:表形式のデータ、ストリーム、ベクトルを扱う統合データ表領域
VAST DataSpace:拠点やクラウドをまたいで、データをひとつの名前空間として見せる仕組み
VAST DataEngine:データの書き込みなどをきっかけに処理を実行するコンピュートリソース
保存、整形、検索という3つの役割が、この4つの要素として同じ基盤の上に揃っている点が、VAST AI OS の特徴です。
最大の違い:データベースを内包していること
従来のストレージの役割は、データを安全に、速く保存することでした。データの意味や構造を扱うのは、別製品として構成するデータベースの仕事です。
VAST AI OSは、DataStore と同じ基盤の上にDataBaseを持っています。これが従来のストレージとの最大の違いです。
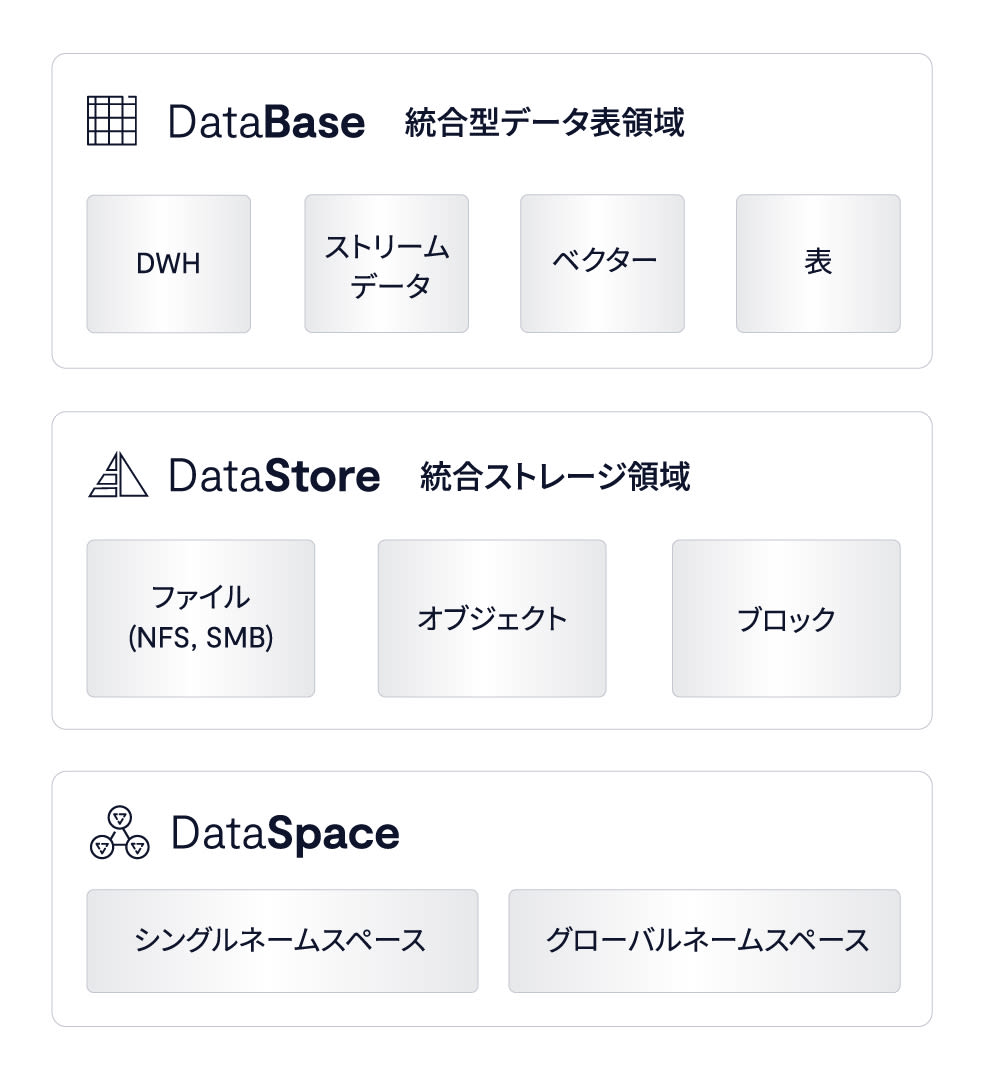
図2 同じ基盤の上に、ストレージ領域とデータベース領域が並ぶ RAG の観点で重要なのは、DataBaseがベクトルをネイティブなデータ型として扱えることです。これによって、先ほどの 3 つの要件への応え方が次のように変わります。
外付けのベクトルデータベースが要らなくなる
ベクトルのためだけに別のシステムを立てる必要がありません。コピーと同期が減るため、RAGが参照するデータと元のデータのずれも生まれにくくなります。
ベクトル検索と条件検索を一度に実行できる
「意味が近い文書」という条件と、「営業部の文書」「今年更新されたもの」といったSQLの条件を、ひとつのクエリで組み合わせられます。問いかけのたびに根拠を的確に絞り込めるので、回答の精度にもつながります。
データ量が増えても検索を続けられる
RAG の利用が広がれば、検索の回数も対象のデータも増えていきます。2026年8月にGAとなったVAST AI OS 5.5では、新しいベクトルインデックスが導入されました。VAST の公表値では、10億件・128次元のベクトルを使った比較で、主要なオープンソースのベクトルデータベースに対して約10倍高速な検索を示しています。
保存と同時に整形する:データが回答に変わる流れ
RAG に求められる「鮮度」に応えるのが、図の見出しにある「保存と同時に、必要な形式にデータを整形」という仕組みです。データが書き込まれた時点で処理が動き、AI が使える形に変えてDataBase に格納します。夜間のバッチ処理を待たずに、新しいデータがすぐに回答の根拠として使えるようになります。
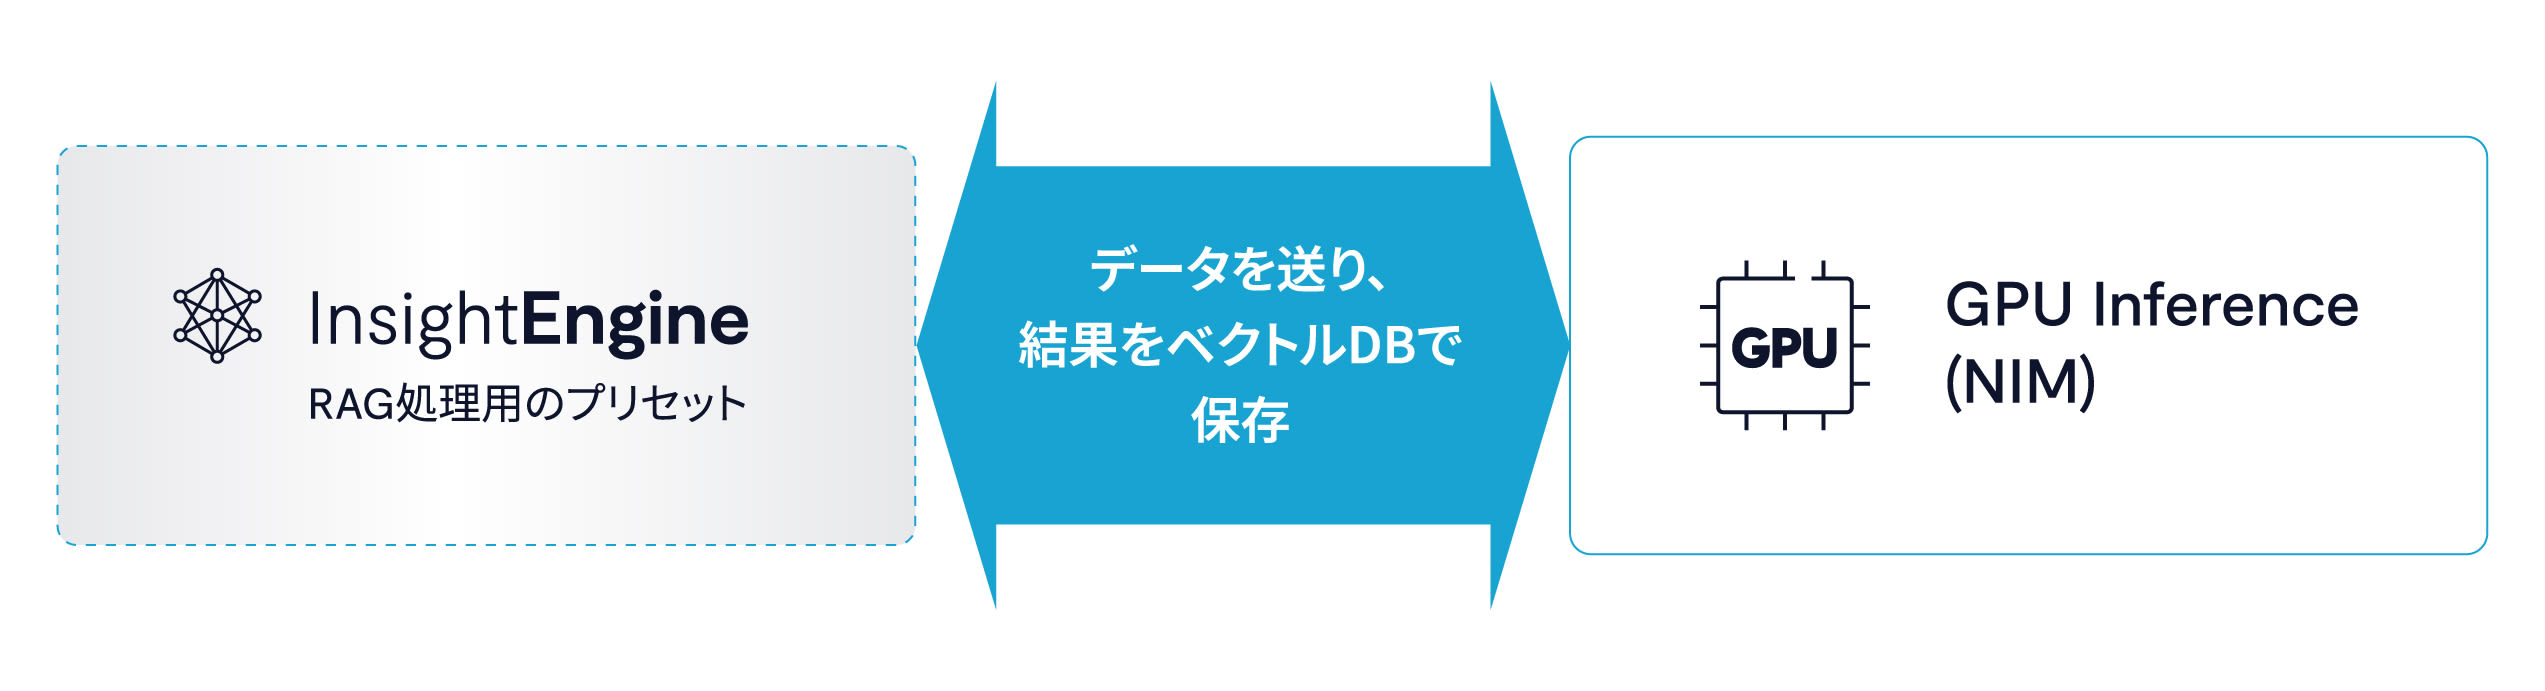
図3 VAST InsightEngineが整形したベクトルを、RAGやAIエージェントが検索する VASTに書き込まれた文書が、RAG の回答に使われるまでの流れは次のとおりです。
起動する:文書の書き込みをきっかけに、DataEngineのトリガーが処理を起動します。5.5では、S3に加えてNFSv4のファイル操作もトリガーにできます。
整形する:RAG処理用のプリセットであるInsightEngineが文書をチャンクに分割し、GPUサーバ上の推論サービス(NVIDIA NIM)でベクトルに変換します。
格納する:チャンクごとに、本文、ベクトル、元ファイルの情報をDataBase に格納します。
検索して回答する:RAGアプリケーションやAIエージェントが質問に近いチャンクを検索し、根拠としてLLMに渡します。
5.5では、1〜3の処理をVAST Cluster内のCNode上で実行できるようになりました。パイプライン専用のKubernetesクラスタは不要です。埋め込みモデルやLLMそのものの計算は、GPUサーバが担います。図4で「GPU Inference(NIM)」が別の枠で描かれているのは、GPUはモデルの計算に、VAST はモデルに渡すデータを整えて届けることに専念する、という役割分担を表しています。
既存のデータをどう持ち込むか:VAST SyncEngine
ここまでの流れは、データがVAST の上にあることが前提です。では、既存のファイルサーバやSaaSにあるデータはどうするのか。その入口として用意されているのが、SyncEngine です。
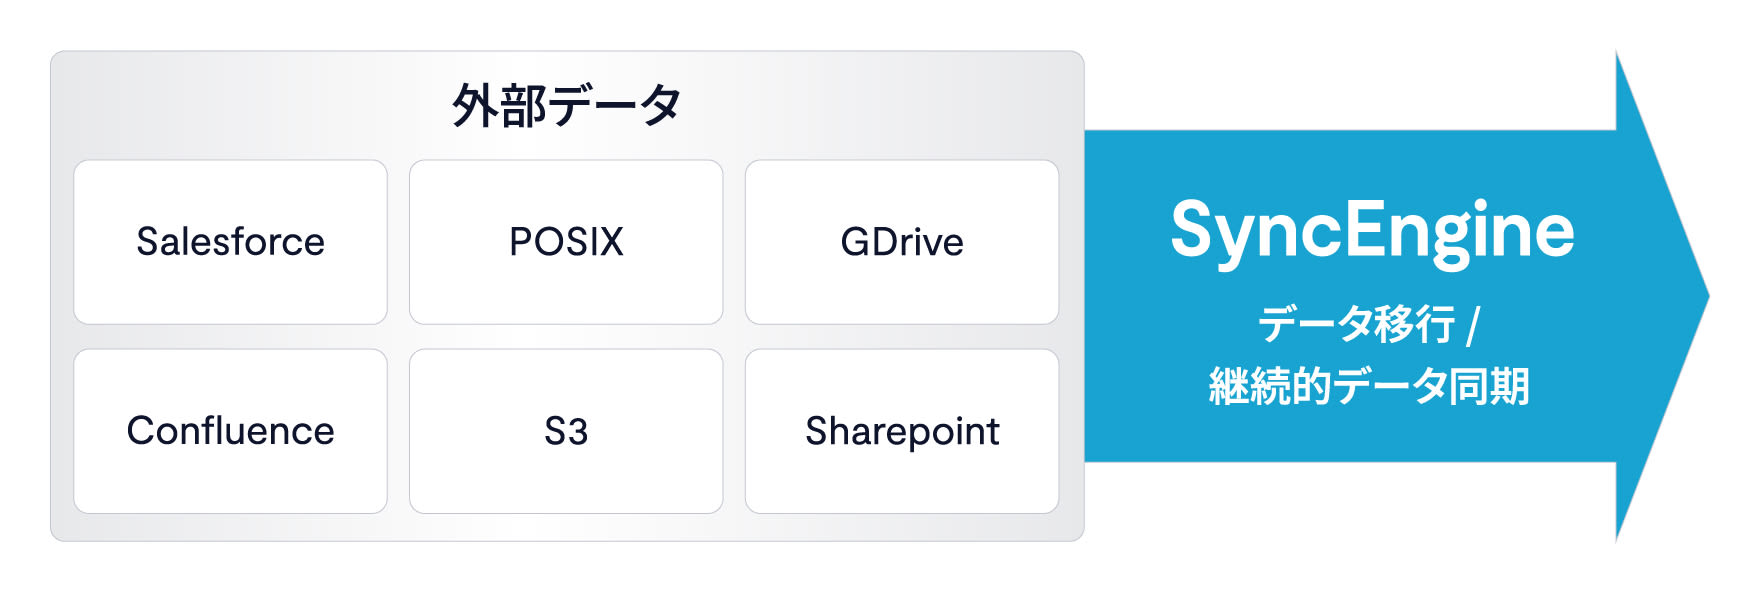
図4 SyncEngine は、既存のシステムとSaaSからデータを取り込む入口になる(図中のSharePointとSalesforceは今後対応予定) データは社内に確かにあるのに、AI まで届かない。通信や物流で最後の区間を指す言葉になぞらえて、VAST Dataはこの状態を「ラストワンマイル」の問題と表現しています。SyncEngine は、この区間を埋めるための機能です。
SyncEngineの中心的な役割は、移行と同期です。ファイルシステムやオブジェクトストレージ、ConfluenceやGoogle DriveといったSaaSからデータを取り込みます。一度きりの移行だけでなく、継続的な取り込みにも対応します。あわせてVAST Catalogも持ち、ファイルシステムについてはメタデータを索引としてDataBase に蓄積し、どこに何があるかを検索できるようにします。SyncEngine は、VAST の顧客に追加費用なしで提供されています。
※ SyncEngineが対応するデータソースと機能は、順次拡大しています。本記事の執筆時点(2026年9月)で取り込みに対応しているのは、POSIXファイルシステム、AWS S3、VAST S3、Azure Blob Storage、Confluence、Google Driveです。Windowsファイルサーバ(SMB)、SharePoint、Salesforceへの対応と、カタログの対象となるデータソースの拡大は、今後対応予定です。最新の対応状況は、VAST Data Japanまでお問い合わせください。
何が要らなくなり、何が残るのか
ここまでの内容を、従来の構成と比べて整理します。
従来の構成で必要だったもの | VAST AI OS では |
|---|---|
外付けのベクトルデータベース | DataBaseがベクトルをネイティブに格納する |
パイプライン用のKubernetesクラスタ | 5.5から、VASTクラスタ内のCNode上で実行できる |
移行・同期ツールや自作スクリプト | SyncEngine で取り込める(対応ソースは拡大中) |
一方で、モデルの計算を担うGPU環境は、引き続き必要です。また、SyncEngineが対応していないデータソースについては、別の手段でVASTにデータを移す必要があります。 RAG に必要な保存・整形・検索を同じ基盤に集めることで、個別に用意していた製品の多くが要らなくなります。
まとめ
RAG では、問いかけのたびに、新しいデータを、使える形で、すぐに届けられるかが問われる
従来の構成が複雑になるのは、保存・整形・検索という役割が別々の製品に分かれているからである
VAST AI OSは同じ基盤の上にデータベースを持ち、保存と同時にデータを整形することで、RAG の構成をシンプルにする
既存のデータを持ち込む入口としてSyncEngineがあり、対応するデータソースは順次広がっている
冒頭で触れたとおり、RAG は推論の一部であり、推論に「知識」を届ける仕組みです。推論が必要とするデータは、それだけではありません。AIエージェントが長い文脈を扱い、何往復も対話を重ねるようになるにつれて、推論の途中経過である「KVキャッシュ」をどこに保持し、どう再利用するかという、もうひとつのデータの課題が大きくなっています。次回の記事では、推論の時代にデータ基盤が担うこの役割を取り上げます。
関連リンク
VAST SyncEngine 製品ページ:https://www.vastdata.com/platform/syncengine
VAST SyncEngine 発表リリース(英語):https://www.vastdata.com/press-releases/vast-data-introduces-syncengine
VAST InsightEngine 製品ページ:https://www.vastdata.com/platform/insightengine
InsightEngine によるリアルタイムRAG(英語):https://www.vastdata.com/blog/unlocking-real-time-ai-with-vast-insightengine
VAST AI OS 5.5 GA のお知らせ(英語):https://www.vastdata.com/blog/vast-ai-os-5-5-is-generally-available


